Bayangkan kamu punya toko yang buka 24 jam. Suatu hari kamu harus pindah ke gedung baru yang lebih besar. Pilihannya dua:
Tutup toko seharian, lalu angkut semua barang sekaligus.
Pindahkan rak satu per satu, sementara pembeli tetap bisa belanja.
Pada 7 Oktober 2026 malam, Storave memilih cara kedua. Kami memindahkan API, database, chat, dan sebelas aplikasi web dari dua server lama ke AWS (layanan cloud milik Amazon) di Singapura. Hasilnya:
Website tidak pernah mati. Selama pindahan, orang tetap bisa mencari tempat titip barang, melihat mitra, dan membuka pesanannya.
Tidak ada data yang hilang. Semua tabel database dicek dan dibandingkan sebelum server baru dipakai. Semuanya sama persis.
Hanya ada jeda sekitar satu sampai dua menit untuk menyimpan data baru. Selama jeda itu, aplikasi menjawab dengan sopan: "Storave sedang pindah server. Coba lagi dalam beberapa detik."
Pindahan ini didukung kredit dari program AWS Activate. Kami menuliskannya di sini karena banyak pelajarannya yang berguna, terutama untuk developer yang baru pertama kali berurusan dengan server.
Downtime artinya waktu ketika aplikasi tidak bisa dipakai sama sekali. Zero downtime artinya tidak ada waktu seperti itu.
Kenapa pindah?
Dua server lama sudah melayani Storave dengan baik. Tapi ada tiga masalah:
Tidak bisa membesar sendiri. Kalau ada promo dan pengunjung tiba-tiba ramai, kapasitas server tetap segitu saja. Di AWS, jumlah server sekarang bisa bertambah otomatis saat ramai, lalu berkurang lagi saat sepi.
Satu server mengerjakan terlalu banyak hal. Aplikasi, database, dan beberapa proyek lain ada di mesin yang sama. Kalau satu bermasalah, yang lain bisa ikut kena.
Backup dan pemantauan belum rapi. Sekarang data dicadangkan otomatis setiap malam, dan ada 21 alarm yang mengirim email ke tim kalau ada yang tidak beres.
Strategi: pindah sedikit demi sedikit
Cara paling gampang adalah "big bang": pasang halaman "sedang maintenance", matikan server lama, pindahkan semuanya, lalu nyalakan server baru. Hitungan kami, itu berarti Storave mati 10 sampai 15 menit.
Kami memilih cara yang namanya strangler pattern. Namanya diambil dari tanaman rambat yang pelan-pelan tumbuh menutupi sebuah pohon. Sistem baru mengambil alih bagian demi bagian, sementara sistem lama tetap melayani bagian yang belum pindah.
Urutannya:
Siapkan rumah baru, lalu salin isinya terus-menerus. Database di AWS kami jadikan replica, yaitu salinan yang otomatis menerima setiap perubahan dari database lama. Jaraknya kurang dari satu detik.
Pindahkan dulu bagian yang tidak menyimpan data. Sebelas aplikasi web (halaman utama, aplikasi mitra, dashboard admin, blog, dan lainnya) dipindah satu per satu. Caranya cukup dengan mengubah DNS, yaitu "buku alamat" internet yang memberi tahu sebuah domain harus diarahkan ke server mana. Kalau ada masalah, alamatnya bisa dikembalikan dalam hitungan detik.
Terakhir, pindahkan API dan database dalam satu waktu yang singkat.
Mode read-only: rahasia "tanpa downtime"
Ini bagian paling penting.
Storave hanya punya satu database utama. Artinya ada satu momen ketika server lama harus berhenti menyimpan data baru, supaya server baru bisa mengambil alih dengan data yang sama persis. Kalau dua database menyimpan data baru di waktu yang sama, datanya bisa terbelah dua: sebagian pesanan ada di sini, sebagian di sana. Itu yang paling kami hindari.
Daripada mematikan seluruh aplikasi, kami membuat mode read-only (hanya baca). Selama mode ini menyala:
Semua permintaan membaca tetap jalan. Contohnya mencari mitra, membuka detail, atau melihat pesanan.
Permintaan menulis, misalnya membuat pesanan atau menyimpan perubahan, dijawab dengan kode 503 yang artinya "sedang tidak bisa, coba lagi nanti". Aplikasi mobile akan mencoba ulang sendiri, dan payment gateway juga mengirim ulang notifikasinya secara otomatis.
Lalu sebuah script menjalankan langkah-langkah ini satu per satu:
Menyalakan mode read-only.
Menutup akses tulis di database lama.
Menunggu salinan di AWS menerima perubahan yang terakhir.
Membandingkan checksum setiap tabel. Checksum itu semacam "sidik jari" dari isi tabel. Kalau isinya sama, sidik jarinya pasti sama.
Menyalin sisa data analytics.
Menjadikan database AWS sebagai database utama.
Mengarahkan DNS API ke server baru.
Kalau ada satu saja checksum yang berbeda, script langsung membatalkan semuanya. Server lama kembali menerima data seperti biasa, dan tidak ada data yang hilang.
Malam itu, semua checksum cocok.
Angka-angka dari malam pindahan
Yang diukur | Hasil |
|---|---|
Jam pindahan | 22.11 WIB. Kami memilihnya setelah melihat log 10 hari terakhir: jam segini sangat sepi |
Lama website tidak bisa dibuka | 0 detik |
Server baru mulai menerima data baru | 66 detik setelah mode read-only menyala |
Jeda menyimpan data paling lama | 137 detik, sampai semua server Cloudflare di dunia mengikuti alamat baru |
Tabel yang dibandingkan | 128 tabel ditambah tabel token login, semuanya sama persis |
Data analytics | Lebih dari 77.800 dokumen, jumlahnya sama persis |
Perubahan yang tertinggal di server lama | Hanya 1 catatan waktu login (dan memang sengaja kami izinkan) |
Target awal kami, jeda menyimpan data hanya 20 detik. Kenyataannya lebih lama. Ada dua penyebab: setiap perintah ke server AWS butuh beberapa detik untuk bolak-balik, dan perubahan DNS butuh waktu untuk menyebar ke seluruh jaringan Cloudflare. Tapi selama itu, membaca data tetap tidak pernah terputus.
Sebelum hari H: membuktikan tidak ada yang berubah
Pindah server seharusnya tidak mengubah apa pun yang dilihat pengguna. Kami tidak mau sekadar berharap, jadi kami membuktikannya:
API dibandingkan. Permintaan yang sama dikirim ke server lama dan server baru. Hasilnya 26 dari 26 jawaban sama persis.
Halaman web dibandingkan. Isi dan header dari 56 halaman dan file kami bandingkan, sampai 56 dari 56 sama persis.
Kode yang dipakai sama persis. Ternyata beberapa aplikasi web di server lama memakai versi kode yang lebih lama dari versi terbaru di repository. Kalau kami memakai versi terbaru, pindahan ini diam-diam juga menjadi rilis fitur baru. Kalau ada yang rusak, kami tidak akan tahu penyebabnya: server baru, atau kode baru? Jadi kami menyalin persis aplikasi yang sedang berjalan. Pindah dulu, rilis belakangan.
2.138 automated test dijalankan untuk mode read-only yang kami tambahkan.
Load test: tiga masalah yang baru ketahuan setelah diuji
Load test artinya menguji server dengan banjir permintaan buatan, untuk melihat seberapa kuat servernya. Kami mengirim sekitar 400 kali lipat beban puncak normal Storave. Semua permintaannya hanya membaca data, dan hanya dikirim ke server baru, jadi pengguna sama sekali tidak terganggu.
Tiga masalah muncul:
Data pemantauan terlalu jarang. Auto scaling (fitur yang menambah server secara otomatis) butuh data setiap menit. Bawaan AWS hanya setiap lima menit. Akibatnya, auto scaling terlambat bereaksi.
CPU "kehabisan kuota". Server tipe hemat di AWS punya jatah performa. Kalau jatahnya habis, kecepatan CPU dibatasi sampai 20%. Anehnya, grafik CPU juga hanya menunjukkan 20%, sehingga auto scaling mengira server masih santai. Solusinya: mengaktifkan mode unlimited, supaya CPU tidak dibatasi diam-diam.
Cache penuh lalu menolak. Redis adalah tempat menyimpan data sementara (cache) supaya aplikasi lebih cepat. Batasnya hanya 128 MB, dan disetel untuk menolak data baru kalau penuh. Saat beban tinggi, 11% permintaan gagal karena ini. Solusinya: menaikkan batasnya, dan menyuruh Redis membuang data sementara yang paling cepat kedaluwarsa lebih dulu.
Setelah ketiganya diperbaiki, tes yang sama bisa melayani dua kali lebih banyak permintaan, dengan nol error. Biaya ketiga load test itu? Sekitar 30 sen dolar.
Seperti apa rumah barunya?
Sebelum membahas keamanan, ini gambaran susunan server Storave setelah pindah. Kalau kamu baru pertama kali melihat diagram seperti ini, bacanya dari atas ke bawah, mengikuti panah: dari pengguna sampai ke database.
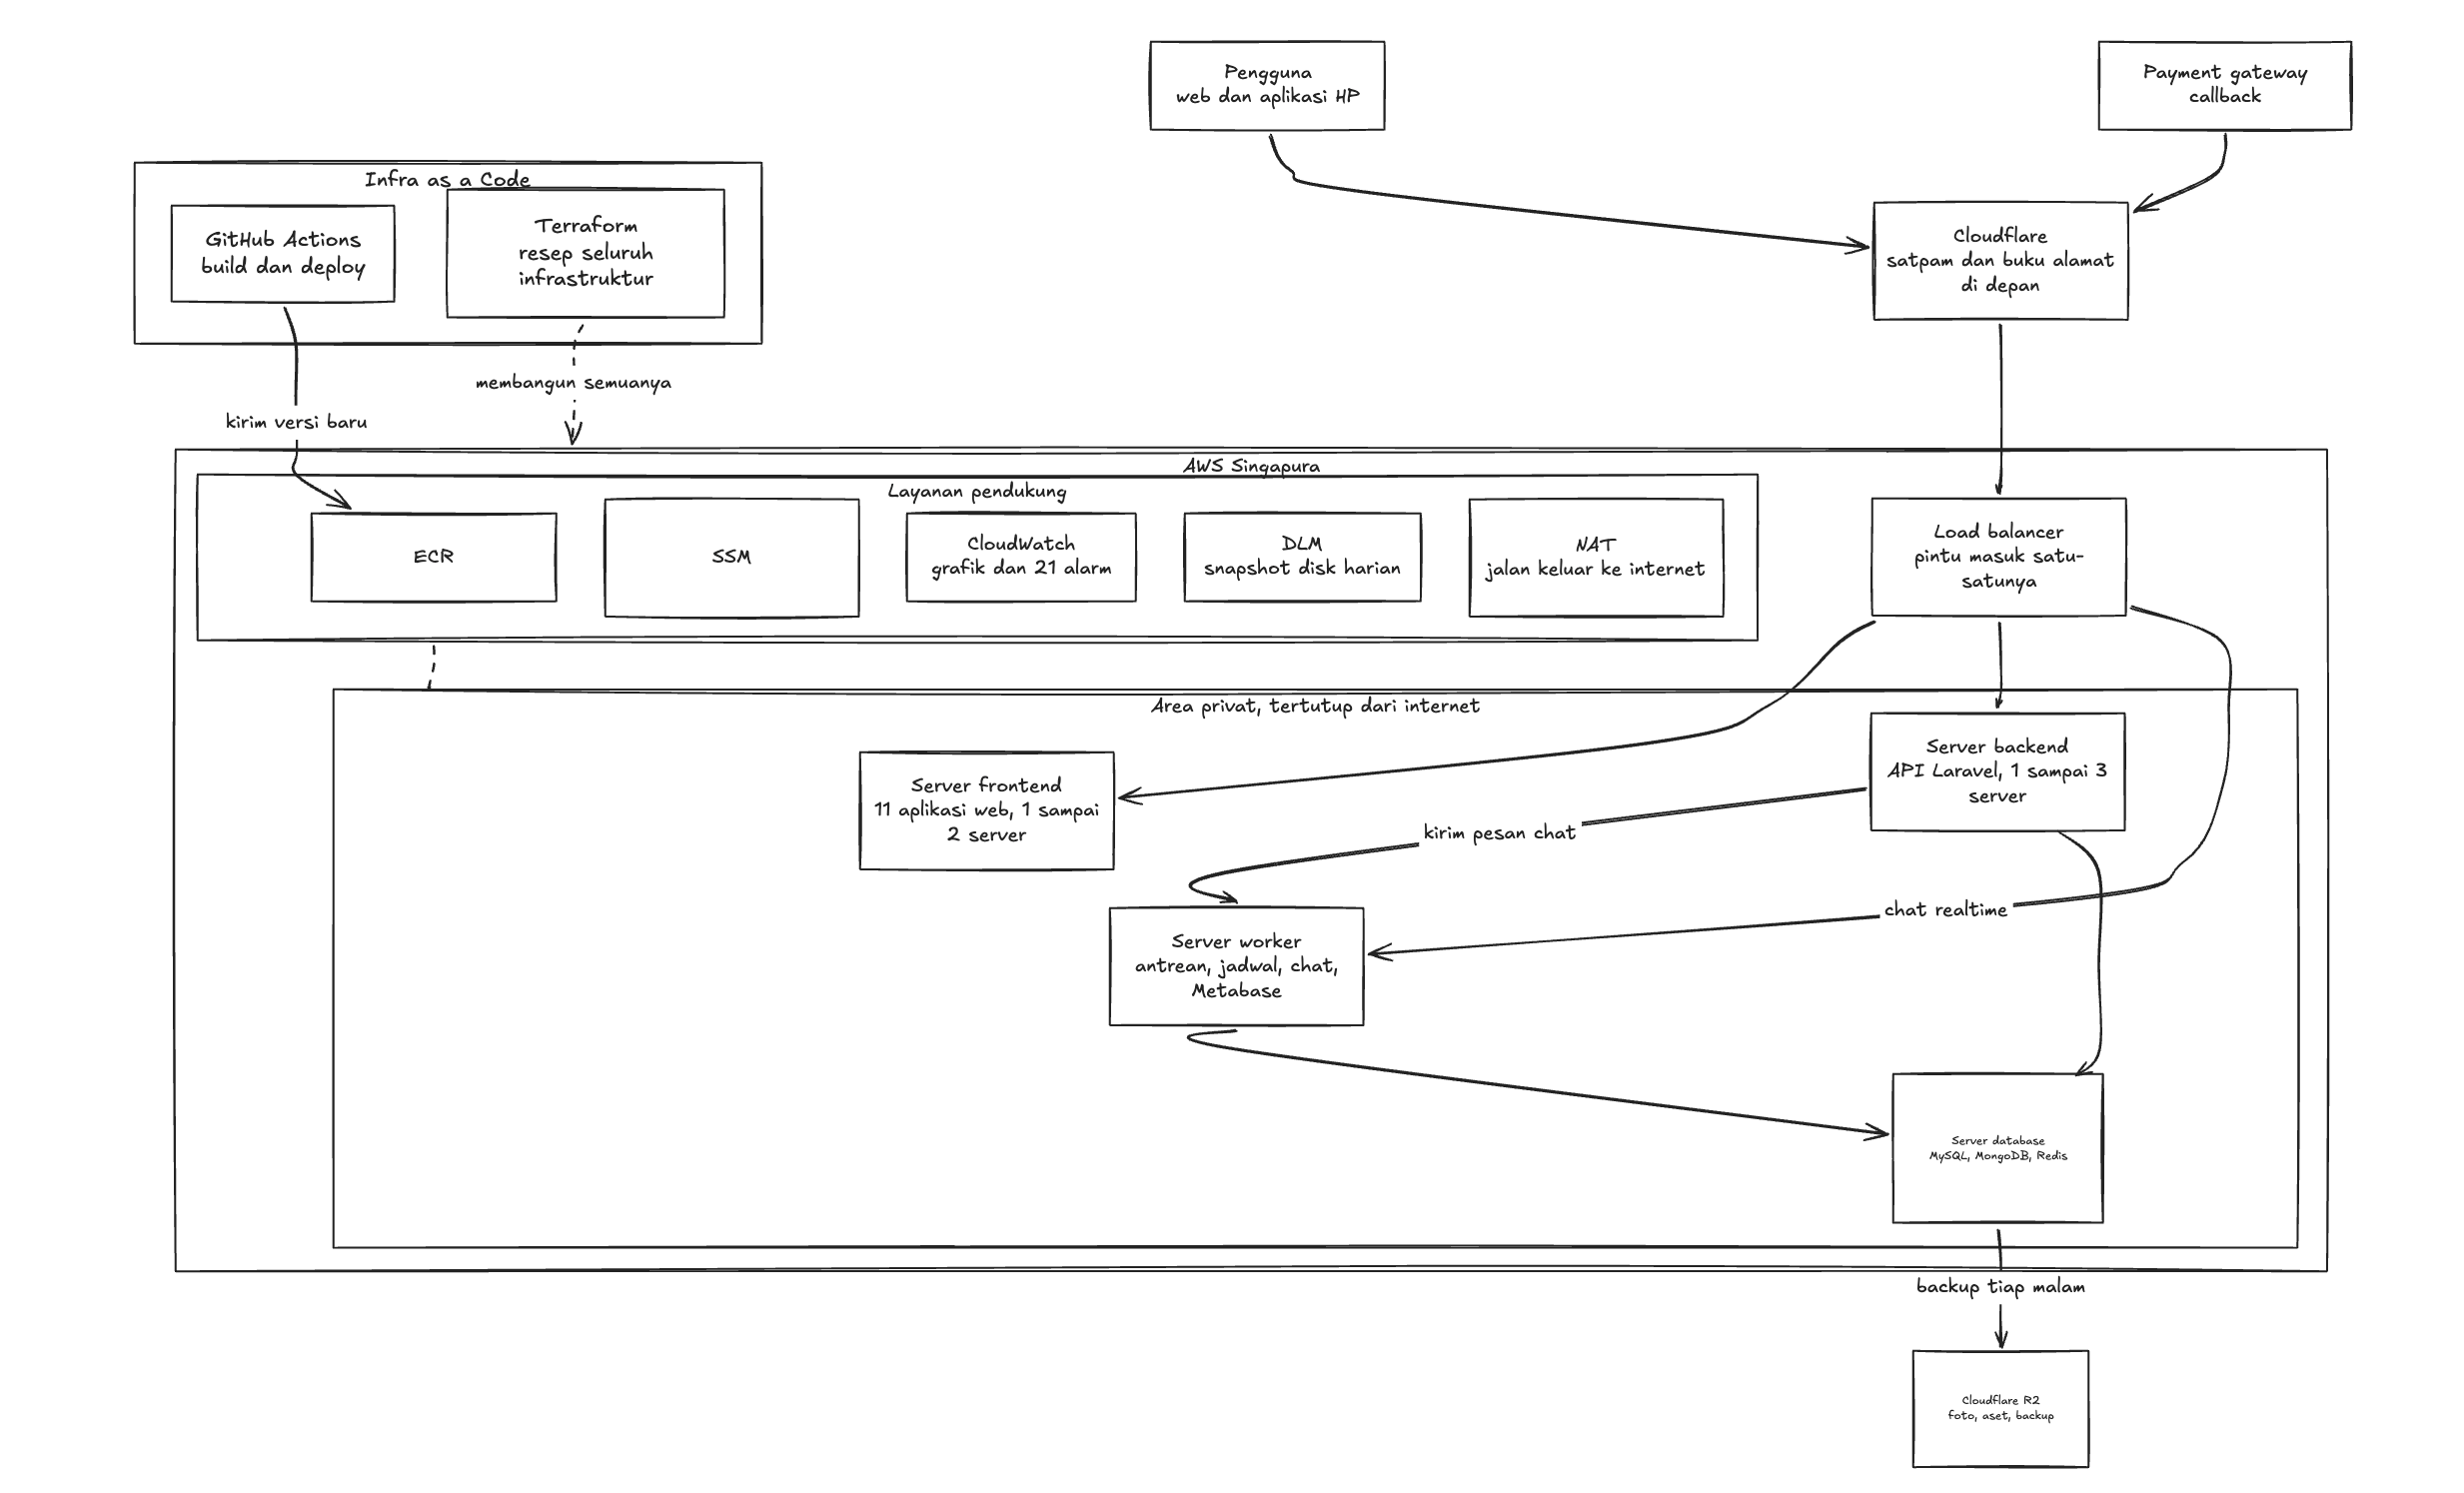
Supaya lebih gampang dibayangkan, anggap saja Storave sebuah gedung perkantoran:
Cloudflare adalah satpam di gerbang depan. Semua tamu harus lewat sini. Ia mengecek tamu yang mencurigakan, dan juga menjadi "buku alamat" (DNS) yang memberi tahu orang di mana gedungnya.
Load balancer adalah resepsionis. Ia menerima tamu dari satpam, lalu mengantarnya ke ruangan yang tepat. Kalau ada beberapa server yang sama, tamunya dibagi rata. Resepsionis ini hanya mau melayani tamu yang datang lewat satpam.
Area privat adalah ruang kerja di dalam gedung. Tidak ada pintu langsung dari jalan ke ruangan ini. Semua server Storave ada di sini.
Server frontend menyajikan tampilan website. Server backend menjalankan API, yaitu "otak" yang memproses pesanan, pembayaran, dan lainnya. Server worker mengerjakan tugas di belakang layar, seperti mengirim WhatsApp, email, pengingat terjadwal, dan chat.
Server database adalah lemari arsip. Hanya backend dan worker yang boleh membukanya.
NAT adalah pintu belakang khusus keluar. Server di dalam bisa keluar ke internet, misalnya untuk menghubungi payment gateway, tapi orang dari luar tidak bisa masuk lewat pintu ini.
Layanan AWS yang kami pakai
Layanan | Penjelasan sederhana |
|---|---|
VPC (Virtual Private Cloud) | "Kompleks berpagar" milik kita sendiri di AWS. Di dalamnya ada area publik dan area privat |
EC2 | Server virtual. Bisa dibayangkan sebagai komputer sewaan di data center AWS |
Auto Scaling Group | Fitur yang menambah server saat ramai dan mengurangi saat sepi. Frontend 1 sampai 2 server (tipe |
EC2 tunggal | Worker ( |
Application Load Balancer | Resepsionis tadi: membagi permintaan ke server yang sehat |
ACM (Certificate Manager) | Sertifikat SSL gratis, supaya koneksinya HTTPS (aman dan terenkripsi) |
NAT instance | Jalan keluar ke internet untuk server di area privat. Kami memakai fck-nat yang biayanya sekitar 8 dolar sebulan, jauh lebih murah dari NAT Gateway bawaan AWS |
ECR (Elastic Container Registry) | Gudang tempat menyimpan image Docker, yaitu paket aplikasi yang siap dijalankan |
Systems Manager | Tempat menyimpan konfigurasi dan password (Parameter Store), dan cara masuk ke server tanpa SSH (Session Manager) |
IAM | Pengatur izin: siapa boleh melakukan apa. Setiap jenis server hanya mendapat izin yang ia butuhkan |
CloudWatch + SNS | Grafik pemantauan dan 21 alarm yang mengirim email ke tim |
Data Lifecycle Manager | Membuat snapshot (foto isi disk) setiap hari dan menyimpannya 7 hari |
S3 | Penyimpanan file. Kami pakai untuk menyimpan catatan Terraform |
AWS Budgets | Alarm biaya, supaya tidak ada tagihan kejutan |
Di luar AWS:
Layanan | Penjelasan sederhana |
|---|---|
Cloudflare | DNS, CDN (mempercepat gambar dan file), WAF (menyaring serangan), dan Access (login tambahan untuk panel admin) |
Cloudflare R2 | Penyimpanan foto, aset, dan backup database yang dienkripsi setiap malam |
GitHub Actions | Robot yang membangun dan merilis aplikasi tanpa downtime, dan bisa kembali ke versi lama kalau ada masalah |
Terraform | Alat untuk menulis seluruh infrastruktur sebagai kode (sekitar dua ribu baris) |
Yang menarik: aplikasinya sendiri tidak berubah. Isinya tetap container Docker yang sama: API Laravel dengan Octane, sebelas aplikasi web, Horizon untuk antrean, Centrifugo untuk chat realtime, dan Metabase untuk dashboard internal. Yang berubah hanya "rumahnya", bukan "isinya".
Kenapa memakai Terraform?
Biasanya orang membuat server di AWS dengan klik-klik di website AWS (console). Cepat untuk hari pertama, tapi setelah beberapa bulan tidak ada yang ingat apa saja yang sudah diklik, dan kenapa.
Dengan Terraform, semua yang ada di diagram tadi (jaringan, server, load balancer, sertifikat, izin, sampai alarm) ditulis sebagai kode. Anggap saja sebagai resep masakan untuk infrastruktur. Untuk migrasi, ini membantu dalam tiga hal:
Bisa dibangun bertahap. Bagian yang gratis dibuat lebih dulu, lalu NAT, database, worker, dan terakhir load balancer serta server aplikasi. Jadi biaya baru jalan ketika memang dibutuhkan.
Setiap perubahan bisa dicek dulu. Perintah
terraform planmenampilkan daftar apa yang akan dibuat, diubah, atau dihapus. Daftar ini selalu dibaca oleh manusia sebelum dijalankan.Bisa dibangun ulang. Kalau suatu hari harus pindah lagi, resepnya sudah ada.
Keamanan juga ikut naik kelas
Pindahan adalah kesempatan bagus untuk sekalian membereskan keamanan:
Server tidak bisa diakses langsung dari internet. Semua harus lewat Cloudflare. Ada juga "kata sandi rahasia" tambahan antara Cloudflare dan load balancer, supaya orang lain yang juga memakai Cloudflare tidak bisa menyelinap langsung ke server kami.
Koneksi lebih ketat. Cloudflare sekarang memeriksa sertifikat server (mode strict), memakai TLS minimal versi 1.2, dan menyalakan HSTS (browser dipaksa selalu memakai HTTPS).
Pintu yang lupa ditutup, kami tutup. Kami menemukan beberapa panel admin internal di server lama yang ternyata bisa dibuka langsung dari internet.
Data di disk dienkripsi, tidak ada lagi kunci SSH yang tersebar di laptop orang, dan semua password disimpan di AWS Parameter Store, bukan di file.
Pelajaran untuk tim lain
Ukur dulu, baru putuskan. Jam pindahan, lama jeda, dan risikonya kami hitung dari log asli, bukan tebakan. Datanya menunjukkan jam 22.00 sampai 01.00 WIB hampir tidak ada transaksi.
Jangan campur pindah server dengan rilis fitur. Kalau ada yang rusak, kamu langsung tahu penyebabnya.
Membaca dan menulis itu berbeda. Dengan mode read-only, "aplikasi mati" berubah menjadi "sebentar tidak bisa menyimpan". Bagi sebagian besar pengguna, itu tidak terasa.
Buat tombol batal otomatis. Script yang berhenti sendiri kalau ada satu angka yang tidak cocok jauh lebih aman daripada mengandalkan keberanian jam 10 malam.
Load test menemukan hal yang tidak terlihat di grafik. Dua dari tiga masalah kami justru membuat grafik terlihat sehat.
Cari ketergantungan yang tersembunyi. Chat realtime kami ternyata masih menempel ke server lama, karena alamatnya ditulis langsung di kode. Ketahuan karena kami memeriksa satu per satu sebelum server lama dimatikan.
Catat semuanya. Setiap langkah, angka, dan kesalahan kami tulis selama proses berjalan. Catatan itulah yang membuat artikel ini bisa ditulis.
Kamus singkat
Istilah | Artinya |
|---|---|
API | "Pelayan" yang menerima permintaan dari aplikasi web dan HP, lalu memproses dan menjawabnya |
Auto scaling | Menambah atau mengurangi jumlah server secara otomatis sesuai keramaian |
Backup | Salinan data cadangan, untuk dipulihkan kalau terjadi masalah |
Cache | Penyimpanan sementara supaya data yang sering dipakai lebih cepat diambil |
Checksum | "Sidik jari" dari sekumpulan data, untuk memastikan dua salinan isinya sama |
Container / Docker | Cara membungkus aplikasi beserta semua kebutuhannya, supaya bisa jalan sama persis di mana saja |
DNS | Buku alamat internet: menerjemahkan nama domain menjadi alamat server |
Downtime | Waktu ketika aplikasi tidak bisa dipakai |
Load balancer | Pembagi lalu lintas ke beberapa server |
Load test | Menguji server dengan banyak permintaan buatan untuk melihat batas kekuatannya |
Replica | Salinan database yang terus mengikuti perubahan dari database utama |
Rollback | Kembali ke versi sebelumnya kalau versi baru bermasalah |
Subnet privat | Bagian jaringan yang tidak bisa diakses langsung dari internet |
Apa yang berubah untuk kamu?
Kalau kamu pengguna Storave: tidak ada yang perlu dilakukan. Aplikasi, akun, pesanan, dan saldo kamu tetap sama. Yang berubah ada di balik layar: Storave sekarang lebih siap menghadapi pengunjung yang ramai, lebih cepat pulih kalau ada masalah, dan datanya terlindungi backup terenkripsi setiap malam.
Terima kasih untuk program AWS Startups yang mendukung perjalanan ini, dan untuk kamu yang tetap titip barang di Storave, bahkan ketika kami sedang pindah rumah.
Tim Engineering Storave